Crawling: qué es, cómo funcionan los crawlers y cómo rastrea Google tu web
Cómo recorren tu web los buscadores y las IA, y qué hacer para que encuentren tus páginas
El crawling es el recorrido llevado a cabo por una araña, bot, robot o crawler (siendo ellos cualquiera de los robots de indexación de los motores de búsqueda) que tiene como objetivo localizar, leer y analizar el contenido presente en una página web.
Unido a esta acción de «investigación» de las arañas de rastreo se encuentra el término crawl budget o presupuesto de rastreo. Google lo define como el conjunto de URL de una web que puede y quiere rastrear, y depende de dos cosas: cuánto puede rastrear sin sobrecargar tu servidor y cuánto interés tiene en tus páginas. Según Google, solo suele preocupar a webs muy grandes, con más de un millón de páginas o más de 10.000 que cambian cada día.
Crawl, crawler y crawling, qué significa cada uno
Son tres palabras de la misma familia. Crawl significa rastrear. Un crawler es el rastreador, también llamado araña o bot. Y el crawling es el rastreo, la acción de recorrer las páginas.
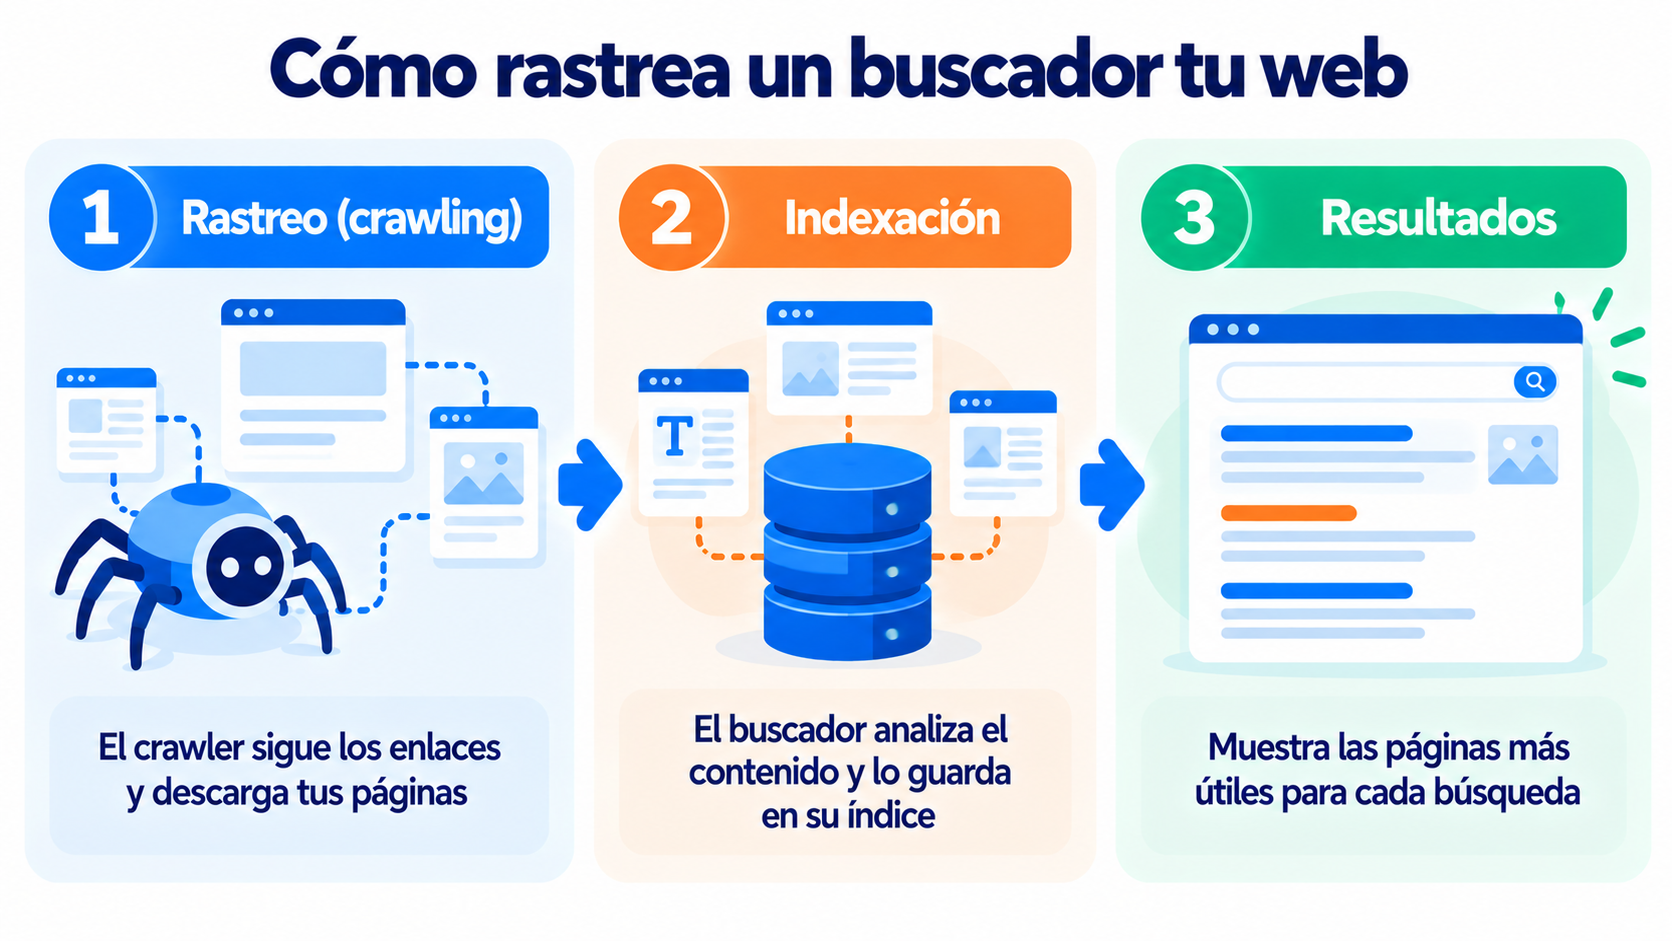
El rastreo es solo el primer paso para aparecer en los motores de búsqueda. Google lo explica en tres fases:
| Fase | Qué pasa | Qué puedes hacer tú |
|---|---|---|
| Rastreo (crawling) | El crawler descubre tu página y la descarga | Enlázala y ponla en el sitemap |
| Indexación | Google analiza el contenido y lo guarda en su índice | Contenido propio, claro y sin errores |
| Resultados | Google muestra las páginas más útiles para cada búsqueda | Responder bien a lo que busca la gente |
Que tus visitas no se queden en una sola lectura
Convierte a quien llega desde Google en suscriptor con los formularios de Mailrelay y sigue en contacto con él. Empieza gratis.
Tipos de web crawlers
Hay distintos tipos de arañas web, que se diferencian sobre todo en el uso para el que se han creado. Principalmente nos podemos encontrar estos tipos de web crawler:
- Web crawler de motores de búsqueda. Son los más conocidos y de uso más común. Cada motor de búsqueda cuenta con su propio web crawler para examinar, recopilar e indexar el contenido de las webs. Algunos de los más populares son Googlebot (Google), Bingbot (Bing), Slurp (Yahoo), DuckDuckBot (DuckDuckGo), Baiduspider (Baidu), YandexBot (Yandex) y Amazonbot (Amazon).
- Web crawler comerciales. Son web crawler con muchas funcionalidades y usos, que crean empresas de software para venderlos a otras.
- Web crawler de escritorio. Son web crawler que se pueden ejecutar en un PC u ordenador portátil. Suelen tener un coste bajo y un uso muy limitado, y normalmente solo pueden rastrear pequeñas cantidades de información y sitios web.
- Web crawler en la nube. Son web crawler que no almacenan los datos en servidores locales, sino en la nube, y que, por norma general, ofrecen como servicio empresas de software. Su principal ventaja es que son escalables.
- Web crawler personalizados. Ofrecen una funcionalidad muy simple y las empresas los usan para tareas muy concretas. Un ejemplo son los que vigilan las posibles caídas de servicios web.
Los rastreadores de la IA
Además de los buscadores, ahora también rastrean la web las empresas de inteligencia artificial. Estos son los más conocidos, según la documentación de cada empresa:
| Rastreador | De quién es | Para qué |
|---|---|---|
| GPTBot | OpenAI | Recoger contenido para entrenar sus modelos |
| OAI-SearchBot | OpenAI | La búsqueda de ChatGPT |
| ClaudeBot | Anthropic | Recoger contenido para entrenar sus modelos |
| PerplexityBot | Perplexity | Mostrar y enlazar webs en sus respuestas |
| Google-Extended | No es un rastreador, sino una instrucción de robots.txt para decidir si tu contenido se usa en su IA |
Puedes permitirlos o bloquearlos en el archivo robots.txt. Ten en cuenta que, si los bloqueas, es más difícil que esas IA citen tu web en sus respuestas. Lo contamos en AEO.
El crawling y el posicionamiento en Google
El crawling es una parte importante del posicionamiento web y del SEO. Google tiene en cuenta cientos de factores para decidir cómo se ordenan los resultados de cada búsqueda.
El funcionamiento del algoritmo no se conoce, lógicamente, pero sí se conocen algunos de los criterios que se tienen en cuenta para posicionar una página web. Muchos de ellos los obtiene con el crawling, entre ellos:
- Enlaces externos que recibe el dominio.
- Facilidad de rastreo para el web crawler.
- La estructura de la página.
- La extensión territorial del dominio.
- La calidad de los contenidos y sus actualizaciones.
- La existencia o no de errores en su HTML.
- Si está optimizada para dispositivos móviles (smartphones y tablets), con responsive design. Desde octubre de 2023, Google rastrea casi todas las webs con su versión para móvil.
- Velocidad de carga de la web.
Hay más condicionantes para el posicionamiento SEO de los que Google hace públicos y, en cada actualización de su algoritmo, cambian o pierden relevancia, por tanto es necesario estar muy atento tras cada actualización.
Cómo facilitar el rastreo de tu web
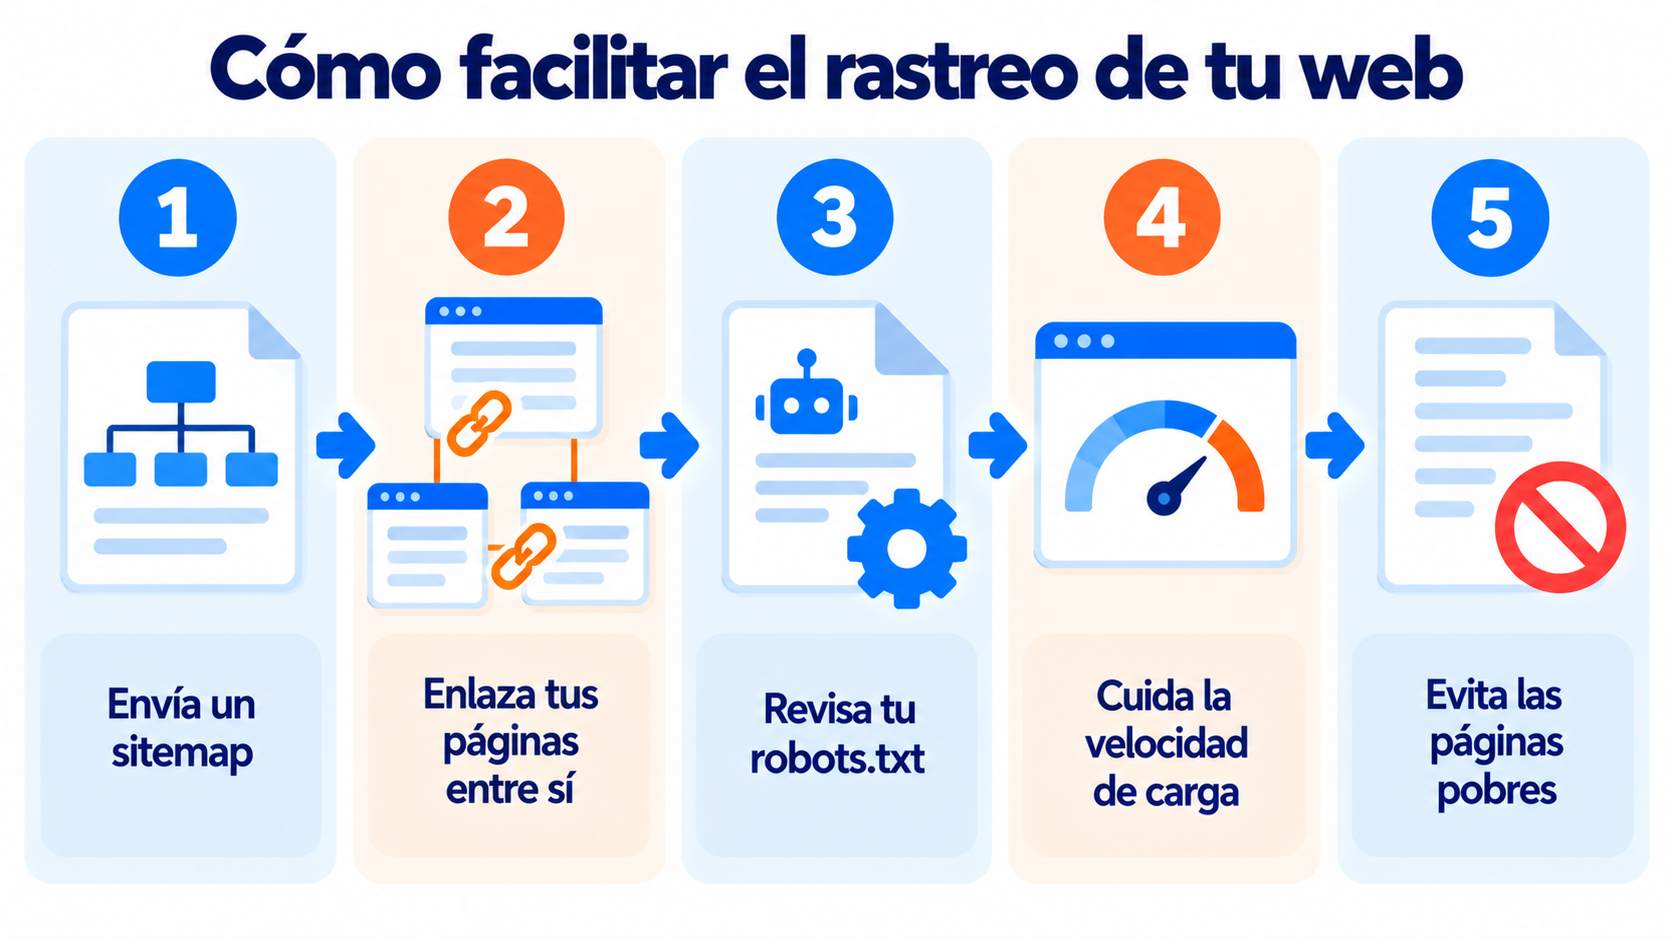
Estos cinco pasos ayudan a que los rastreadores encuentren tus páginas importantes:
- Envía un sitemap a Search Console.
- Enlaza tus páginas entre sí con un buen enlazado interno.
- Revisa tu robots.txt para no bloquear por error lo que quieres que se vea.
- Cuida la velocidad y evita errores y redirecciones en cadena.
- No llenes la web de páginas pobres (thin content) que gasten el rastreo.
El crawling y tus formularios de captación
Un crawler no rellena formularios. Lo que esté detrás de un formulario, como un ebook o una guía descargable, Google no lo ve.
Por eso conviene que la página del formulario tenga texto propio: qué ofreces, para quién es y qué va a recibir el suscriptor. Así tu lead magnet también puede posicionar.
Cómo te ayuda Mailrelay
Con Mailrelay creas formularios de suscripción con doble opt-in para poner en las páginas que más visitas reciben. Con una automatización de bienvenida, incluida también en la cuenta gratuita, envías el lead magnet en cuanto alguien se suscribe.
Y la cuenta gratuita incluye 80.000 emails al mes y 20.000 contactos.
Convierte tu tráfico orgánico en suscriptores
Capta emails en las páginas que más visitas reciben y envía tus novedades a quien ya te ha encontrado. Hasta 80.000 emails al mes gratis con Mailrelay.
Preguntas frecuentes
¿Qué significa crawling en español?
Significa «rastreo». Es el recorrido que hace un robot de un buscador por las páginas de una web para descubrir su contenido.
¿Qué es un crawler?
Es el programa que rastrea las webs. También se le llama araña, rastreador o bot. El más conocido es Googlebot.
¿Qué diferencia hay entre rastrear e indexar?
Rastrear es descubrir y descargar la página. Indexar es analizarla y guardarla en el índice del buscador. Una página puede rastrearse y no llegar a indexarse.
¿Qué es el crawl budget?
Es el conjunto de páginas que Google puede y quiere rastrear de tu web. Solo suele preocupar en webs muy grandes o que cambian mucho cada día.
¿Puedo impedir que las IA rastreen mi web?
Sí. En el archivo robots.txt puedes bloquear rastreadores como GPTBot o ClaudeBot. Si lo haces, es más difícil que esas IA citen tu web en sus respuestas.